Docker Skills: cuando el agente ya sabe Docker, pero necesita aprender cómo querés trabajar
Soy Roxs 👩💻| Software Developer | DevOps | DevSecOps | en @295DevOps 🖼 Content Creator. No se puede crecer si no estas dispuesto a saltar a la zona de peligro 🔥
Los agentes de IA ya saben bastante de Docker.
Podés abrir Kiro, Claude Code, Codex, GitHub Copilot, Cursor o cualquier otro coding agent moderno y pedirle:
Containerizá esta aplicación.
Probablemente obtengas un Dockerfile.
También podés pedir:
Optimizá esta imagen para producción.
Y seguramente el agente intente aplicar multi-stage builds, mejorar el caching de capas, reducir el tamaño de la imagen y quizás ejecutar el proceso con un usuario no root.
Entonces aparece una pregunta bastante razonable:
Si los modelos ya conocen Docker, ¿para qué necesitamos Docker Skills?
Ahí está justamente lo interesante.
El problema que Docker Skills intenta resolver no es solamente de conocimiento.
Es un problema de consistencia.
Y para quienes trabajamos en DevOps, Platform Engineering o Developer Experience, esa diferencia es enorme.
Saber hacer algo no significa hacerlo siempre de la misma manera
Pensemos en un equipo humano.
Un engineer con experiencia probablemente sabe cómo construir una imagen Docker correctamente.
Pero aun así las organizaciones mantienen:
estándares de desarrollo, patrones de arquitectura, políticas de seguridad, runbooks, checklists, documentación y convenciones internas.
¿Por qué?
Porque confiar únicamente en lo que cada persona recuerda o considera correcto genera variabilidad.
Con los agentes de IA ocurre algo parecido.
Un modelo puede conocer muchas formas válidas de resolver un problema.
Pero su respuesta puede cambiar según:
el modelo utilizado;
el contexto disponible;
el contenido del repositorio;
las instrucciones anteriores;
la forma en que escribimos el prompt.
El conocimiento está.
Lo que no necesariamente está es el procedimiento que queremos que siga.
Ahí aparecen las Skills.
Docker las define como su guía oficial y open source para que agentes de programación compatibles puedan ejecutar tareas relacionadas con Docker.
Una forma simple de visualizarlo sería:
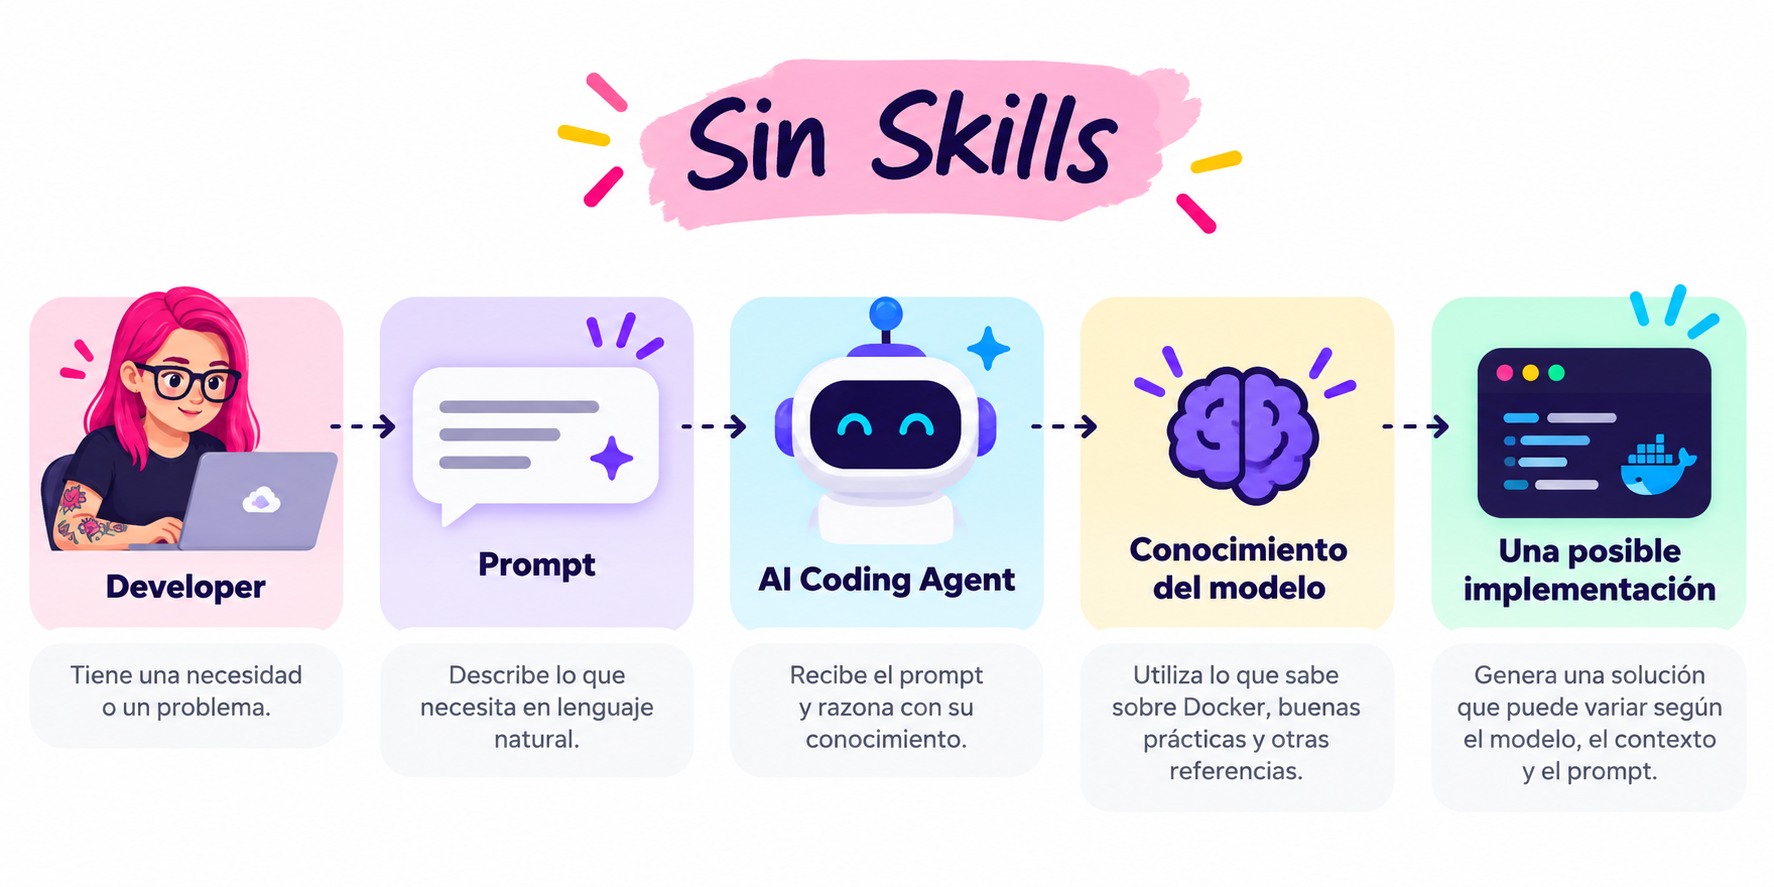
Mientras que con Skills:
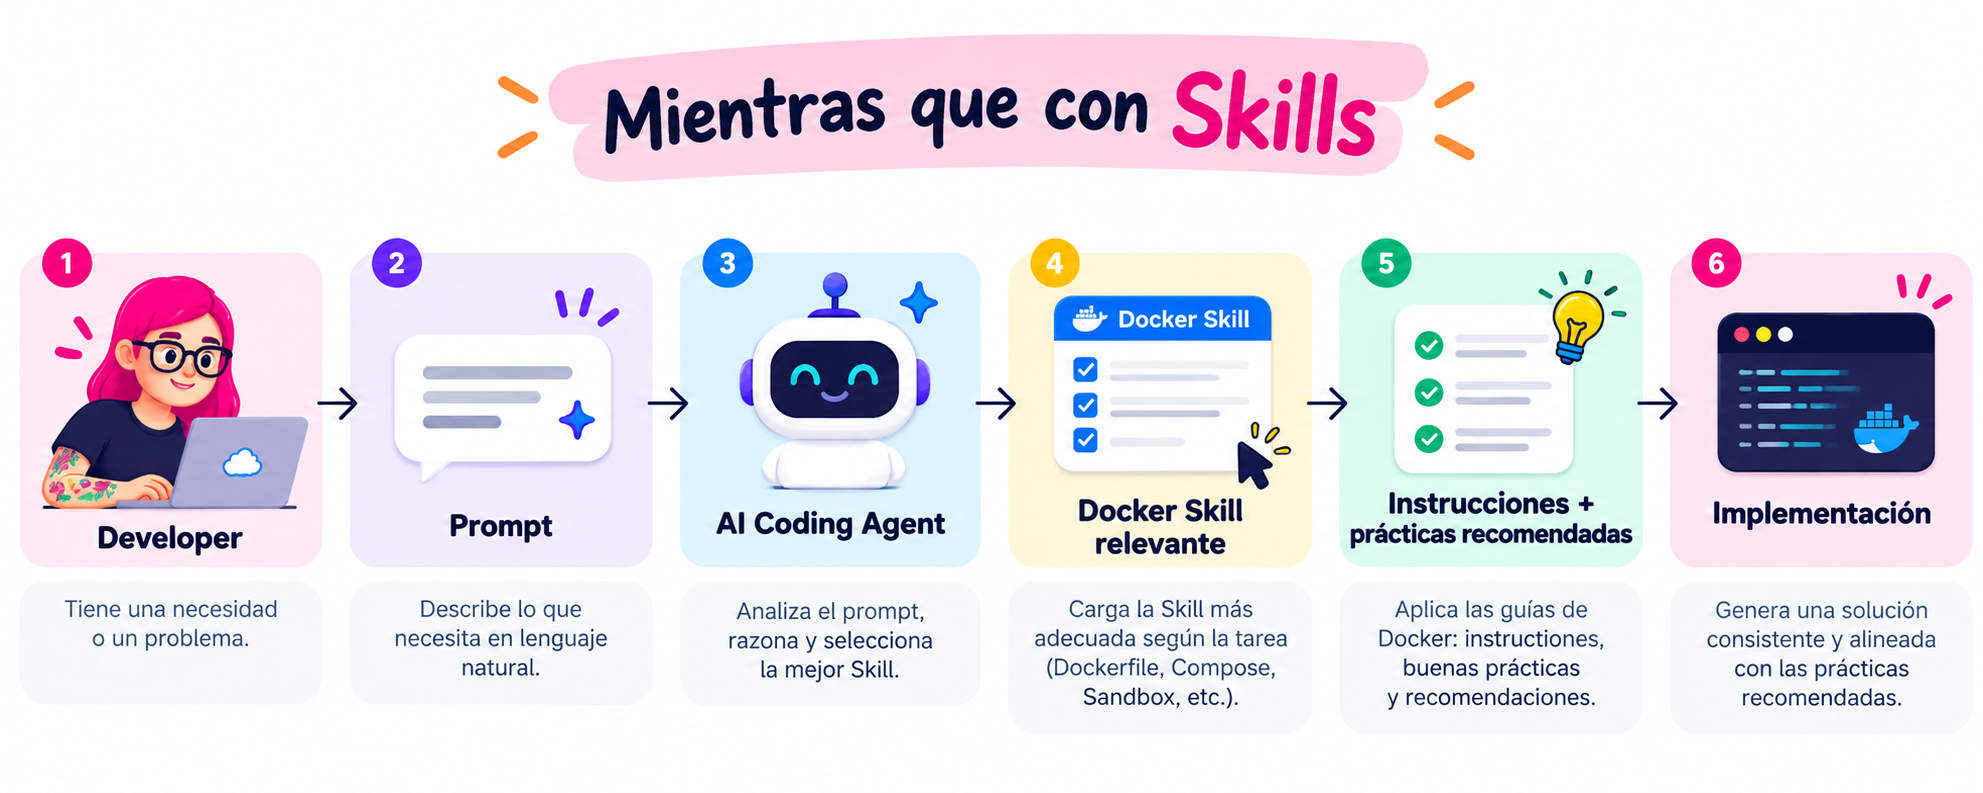
El modelo sigue razonando.
La Skill no reemplaza al modelo.
Le agrega un playbook.
Entonces, ¿qué es exactamente una Skill?
Docker utiliza el formato de Agent Skills.
Cada Skill vive básicamente como un directorio que contiene un archivo:
SKILL.md
Ese archivo describe cuándo utilizar la Skill y cómo ejecutar determinado tipo de tarea.
Puede además incluir referencias, assets y otros recursos.
Lo interesante es que, con un agente compatible, no necesariamente tenemos que escribir:
Usá docker-build-strategies.
Podemos simplemente pedir:
Hacé más pequeña esta imagen Docker y asegurate de que la aplicación no corra como root.
El agente analiza nuestra intención, compara el pedido con las Skills disponibles y carga las instrucciones correspondientes.
Docker explica que un agente compatible selecciona Skills a partir de sus descripciones y que puede combinar varias cuando una tarea involucra más de un producto o etapa.
Esto acerca bastante el concepto a algo que ya conocemos en ingeniería:
documentación ejecutable para agentes.
No necesariamente código.
No necesariamente una herramienta.
Sino contexto operativo estructurado.
Del README para humanos al contexto para agentes
Durante años construimos Developer Experience pensando principalmente en humanos.
Tenemos algo como:
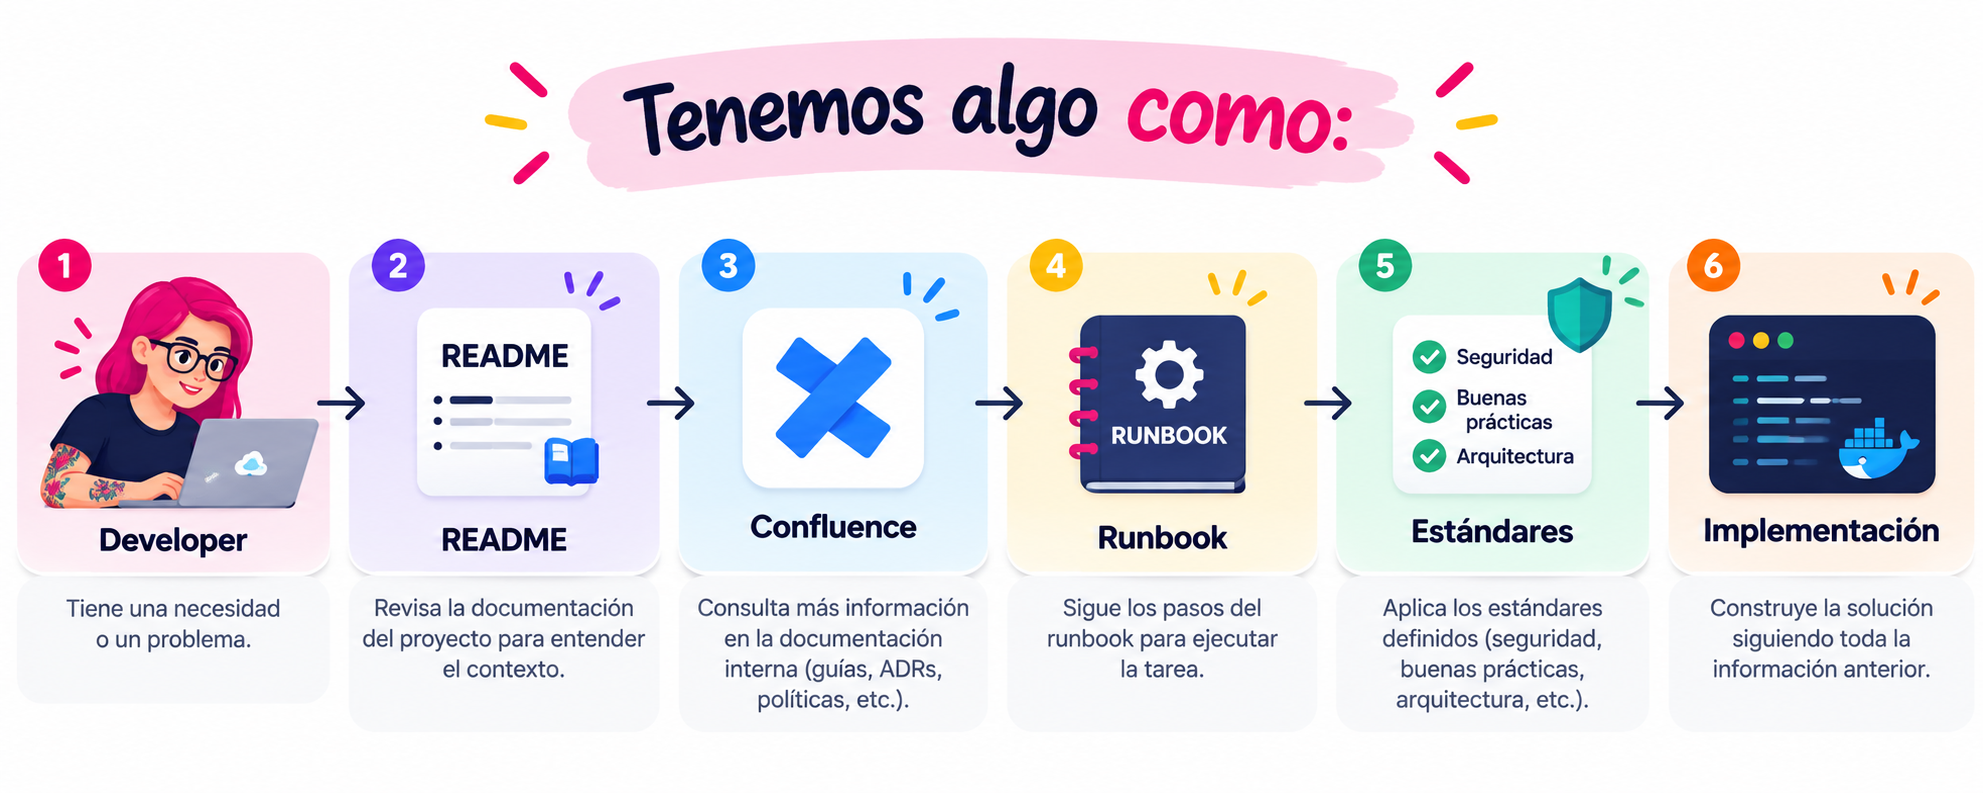
El problema es bastante conocido.
La documentación existe.
Otra cosa es que alguien la encuentre, la lea, esté actualizada y la aplique correctamente.
Con agentes haciendo cada vez más trabajo sobre nuestros repositorios, aparece una nueva necesidad:
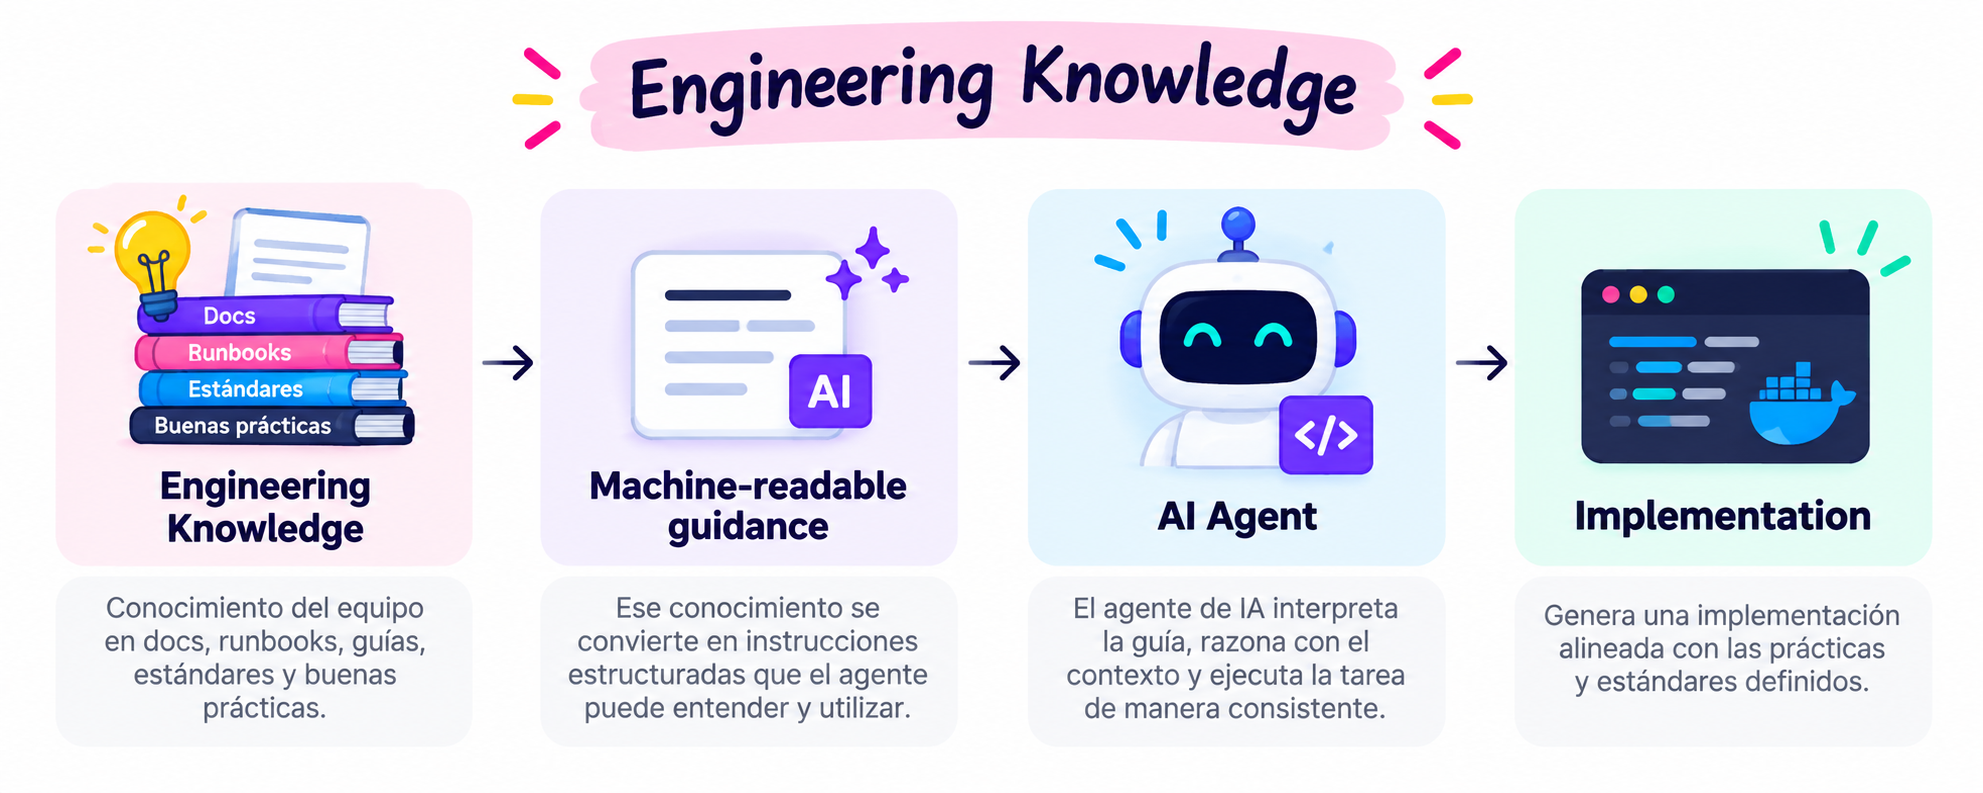
Y creo que ahí está la parte más interesante de Docker Skills.
No solamente en mejorar un Dockerfile.
Sino en la idea de transformar conocimiento operativo en instrucciones reutilizables que puedan acompañar al agente mientras trabaja.
Para alguien que trabaja en Platform Engineering o Developer Experience, esto debería sonar bastante familiar.
Llevamos años intentando hacer exactamente eso mediante golden paths, templates, pipelines, policies y plataformas internas.
Las Skills son otra pieza dentro de ese mismo problema.
¿Qué publicó Docker?
El repositorio oficial docker/skills organiza actualmente sus Skills en varias familias.
| Área | Qué busca resolver |
|---|---|
| Dockerfile & Build | Inicializar proyectos, containerizar aplicaciones, optimizar y endurecer imágenes |
| Docker Compose | Crear configuraciones Compose mantenibles para aplicaciones multi-container |
| Docker Sandboxes | Ejecutar agentes en microVMs aisladas y administrar networking, credenciales y entornos |
| Docker Agent | Configurar, ejecutar y distribuir agentes construidos con Docker Agent |
| Cross-product | Aplicar políticas y guardrails comunes |
Dentro del repositorio encontramos, por ejemplo:
docker-project-foundations
docker-build-strategies
docker-compose-patterns
docker-sandboxes-lifecycle
docker-sandboxes-network-credentials
docker-sandboxes-env
docker-sandboxes-kits
docker-agent-config
docker-agent-run
docker-agent-deploy
docker-destructive-guardrails
Y hay otro detalle importante.
No existe necesariamente una Skill central que cargue todo.
Cada Skill declara cuándo corresponde utilizarla.
Cuando una tarea necesita varias, Docker define incluso un orden lógico entre ellas.
Por ejemplo, si un proyecto todavía no tiene configuración Docker, tiene sentido establecer primero sus fundamentos antes de optimizar el build o generar Compose.
Eso empieza a parecer menos un conjunto de prompts y más un pequeño workflow de conocimiento.
Un ejemplo: mejorar un Dockerfile
Supongamos que tenemos algo bastante básico:
FROM node:22

WORKDIR /app

COPY . .

RUN npm install

CMD ["npm", "start"]
Podríamos pedirle a nuestro agente:
Optimize this Dockerfile for production.
Reduce image size and improve build caching.
The application shouldn't run as root.
Un LLM probablemente podría resolverlo sin ninguna Skill.
Ese no es el punto.
La diferencia está en que, teniendo instalada docker-build-strategies, el agente dispone además del playbook mantenido por Docker para esa categoría de trabajo.
La relación cambia de:
¿Qué sabe mi modelo sobre Docker?
a algo más parecido a:
¿Qué sabe mi modelo
+
qué instrucciones especializadas tiene disponibles
para resolver esta tarea?
Es una diferencia pequeña conceptualmente, pero muy importante cuando empezamos a delegar cambios reales de ingeniería.
Compose es otro buen ejemplo
Imaginemos que tenemos:
frontend
backend
postgres
redis
Y escribimos:
Create a local development environment using Docker Compose for this repository.
El problema no consiste únicamente en saber la sintaxis de compose.yaml.
Hay decisiones alrededor de:
health checks, dependencias, networking, persistencia, secretos, configuración y lifecycle de los servicios.
La Skill docker-compose-patterns agrega instrucciones específicamente orientadas a generar configuraciones Compose robustas y mantenibles.
Otra vez:
el valor no está solamente en que el agente pueda escribir YAML.
Está en reducir cuántas decisiones importantes quedan libradas a una generación diferente cada vez.
Los guardrails son probablemente la parte más importante
Hay un punto donde los agentes dejan de ser solamente asistentes que generan texto.
Empiezan a ejecutar comandos.
Y entonces algo como:
docker system prune -a
ya no es simplemente una recomendación dentro de un chat.
Puede tener consecuencias reales.
Docker incluye una Skill transversal llamada:
docker-destructive-guardrails
orientada justamente a operaciones irreversibles o destructivas. El objetivo es introducir confirmaciones antes de ejecutar determinados cambios.
Esto muestra algo que me parece fundamental para toda la conversación sobre agentes.
Cuanto más autónomo es el agente, más importantes se vuelven:
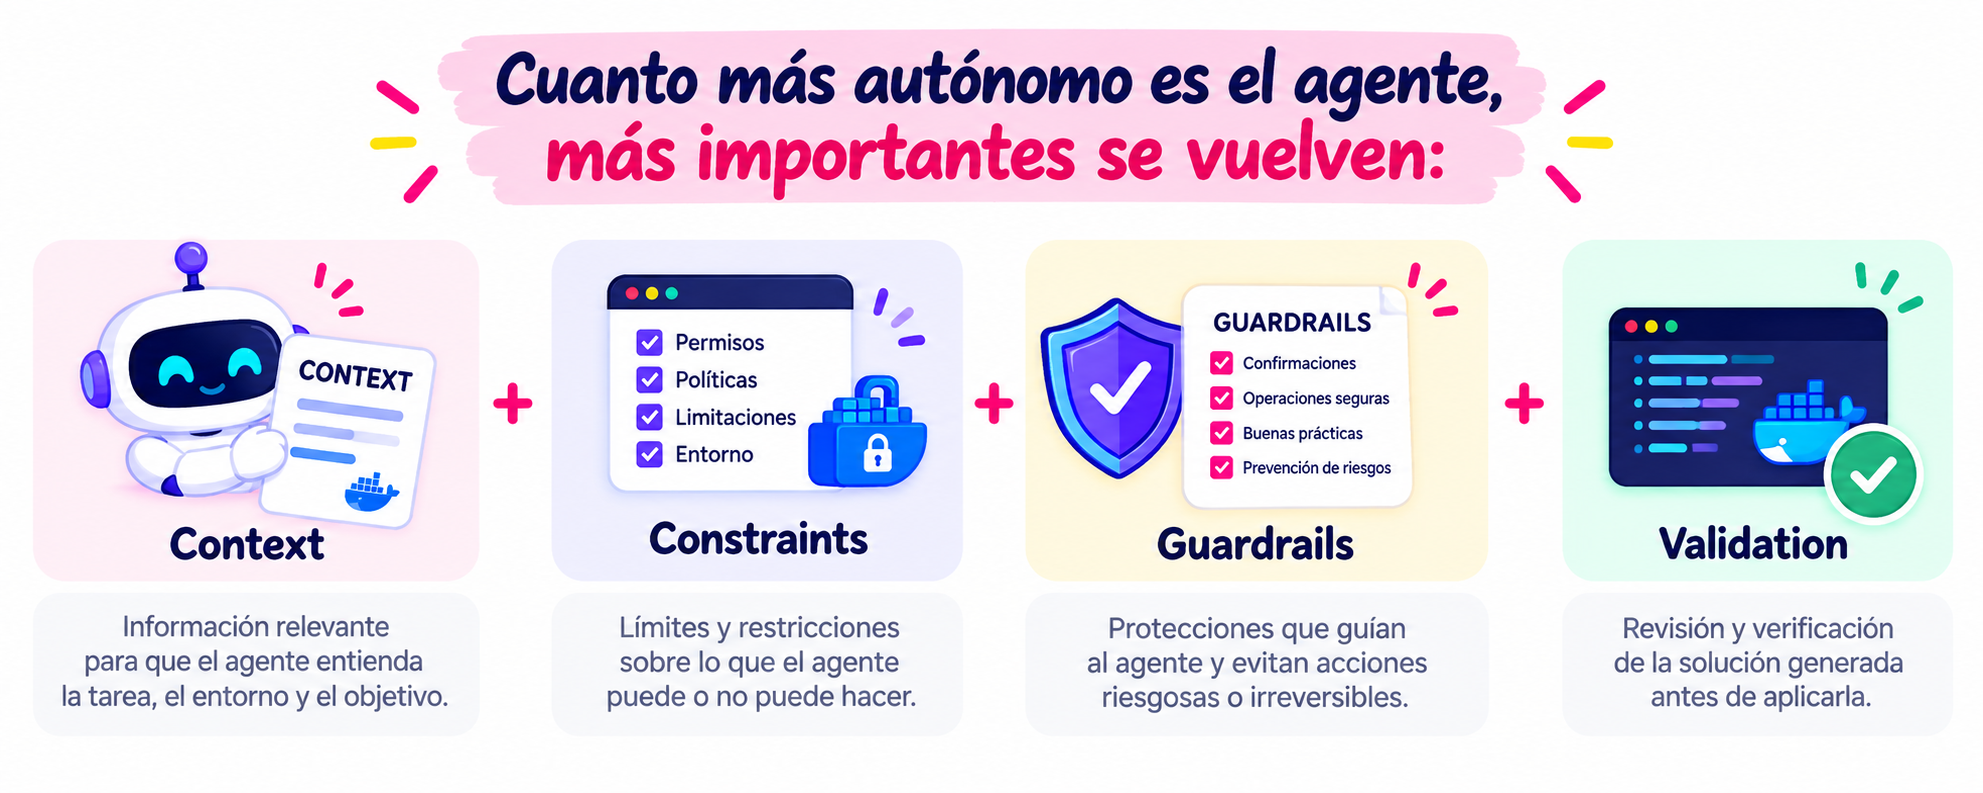
No alcanza con tener un modelo mejor.
Necesitamos mejores límites alrededor del modelo.
Y acá aparece Docker Sandboxes
Docker Skills no se limita a enseñarle al agente cómo generar Dockerfiles.
El repositorio también incluye Skills relacionadas con Docker Sandboxes.
Docker describe Sandboxes como entornos aislados donde coding agents pueden ejecutarse dentro de microVMs, con soporte para aspectos como lifecycle, networking, credenciales y entornos.
Esto conecta dos problemas interesantes.
Por un lado:
¿Cómo debería trabajar el agente?
Skills.
Y por otro:
¿Dónde debería trabajar el agente?
Sandbox.
Podemos imaginar una arquitectura parecida a:
Developer
    ↓
Coding Agent
    ↓
Docker Skills
    ↓
Docker Sandbox
    ↓
Repository / tools / dependencies
El agente obtiene instrucciones especializadas y, al mismo tiempo, un entorno más controlado donde ejecutar el trabajo.
Para mí, esta combinación es mucho más interesante que pensar las Skills solamente como “mejores prompts”.
Docker Agent también entra en el juego
El repositorio incluye además Skills específicas para Docker Agent.
Actualmente aparecen tres áreas:
docker-agent-config
        ↓
docker-agent-run
        ↓
docker-agent-deploy
Es decir:
configurar el agente, ejecutarlo y finalmente distribuirlo o desplegarlo.
Docker especifica incluso ese orden cuando una tarea atraviesa todo el lifecycle.
De nuevo aparece el patrón.
No estamos simplemente acumulando conocimiento.
Estamos describiendo cómo realizar un trabajo.
¿Cómo probar Docker Skills?
Docker ofrece varias formas de instalación.
Una de las más simples utiliza el CLI de Skills:
npx skills add docker/skills
El CLI permite seleccionar qué Skills instalar y para qué agentes.
Podemos inspeccionar primero el catálogo:
npx skills add docker/skills --list
Instalar solamente una Skill:
npx skills add docker/skills \
  --skill docker-compose-patterns \
  --yes
O instalar todas las Skills para los agentes detectados:
npx skills add docker/skills --all
También podemos actualizarlas:
npx skills update
El repositorio documenta soporte o mecanismos de instalación para múltiples coding agents, incluyendo Claude Code, OpenAI Codex, Cursor, GitHub Copilot CLI, Gemini CLI, OpenCode, Windsurf, Cline y Kiro, entre otros.
Esto también es importante porque evita ligar la idea de Skills exclusivamente a un único proveedor de modelos.
Incluso podemos versionarlas
Hay otro detalle que me gustó especialmente desde una mirada DevOps.
El branch main funciona como canal de desarrollo continuo, mientras que Docker publica tags que representan snapshots revisados e inmutables.
Por eso podemos fijar una versión determinada:
npx skills add \
  https://github.com/docker/skills/tree/vX.Y.Z \
  --skill docker-compose-patterns \
  --yes
Docker recomienda utilizar releases versionadas cuando queremos instalaciones reproducibles.
Y esto abre una conversación muy interesante.
Si las instrucciones que utilizan nuestros agentes afectan cómo se modifica nuestro software...
¿no deberíamos versionarlas igual que cualquier otra dependencia de ingeniería?
Probablemente sí.
Skills no significa confiar ciegamente en el agente
Hay una frase de la documentación de Docker que conceptualmente me parece más importante que cualquier comando de instalación:
las Skills ayudan al agente, pero no reemplazan la validación.
Docker recomienda revisar los cambios y comandos propuestos, ejecutar los tests del proyecto y confirmar las operaciones destructivas antes de aprobarlas.
Eso también define bastante bien dónde estamos hoy con Agentic Engineering.
Podemos delegar más.
Podemos automatizar más.
Podemos darle al agente mejores herramientas.
Pero sigue existiendo una diferencia entre:
generar una solución
y
hacerse responsable de las consecuencias de esa solución.
Para mí, esa última parte sigue siendo humana.
¿Cuándo tiene sentido usar una Skill?
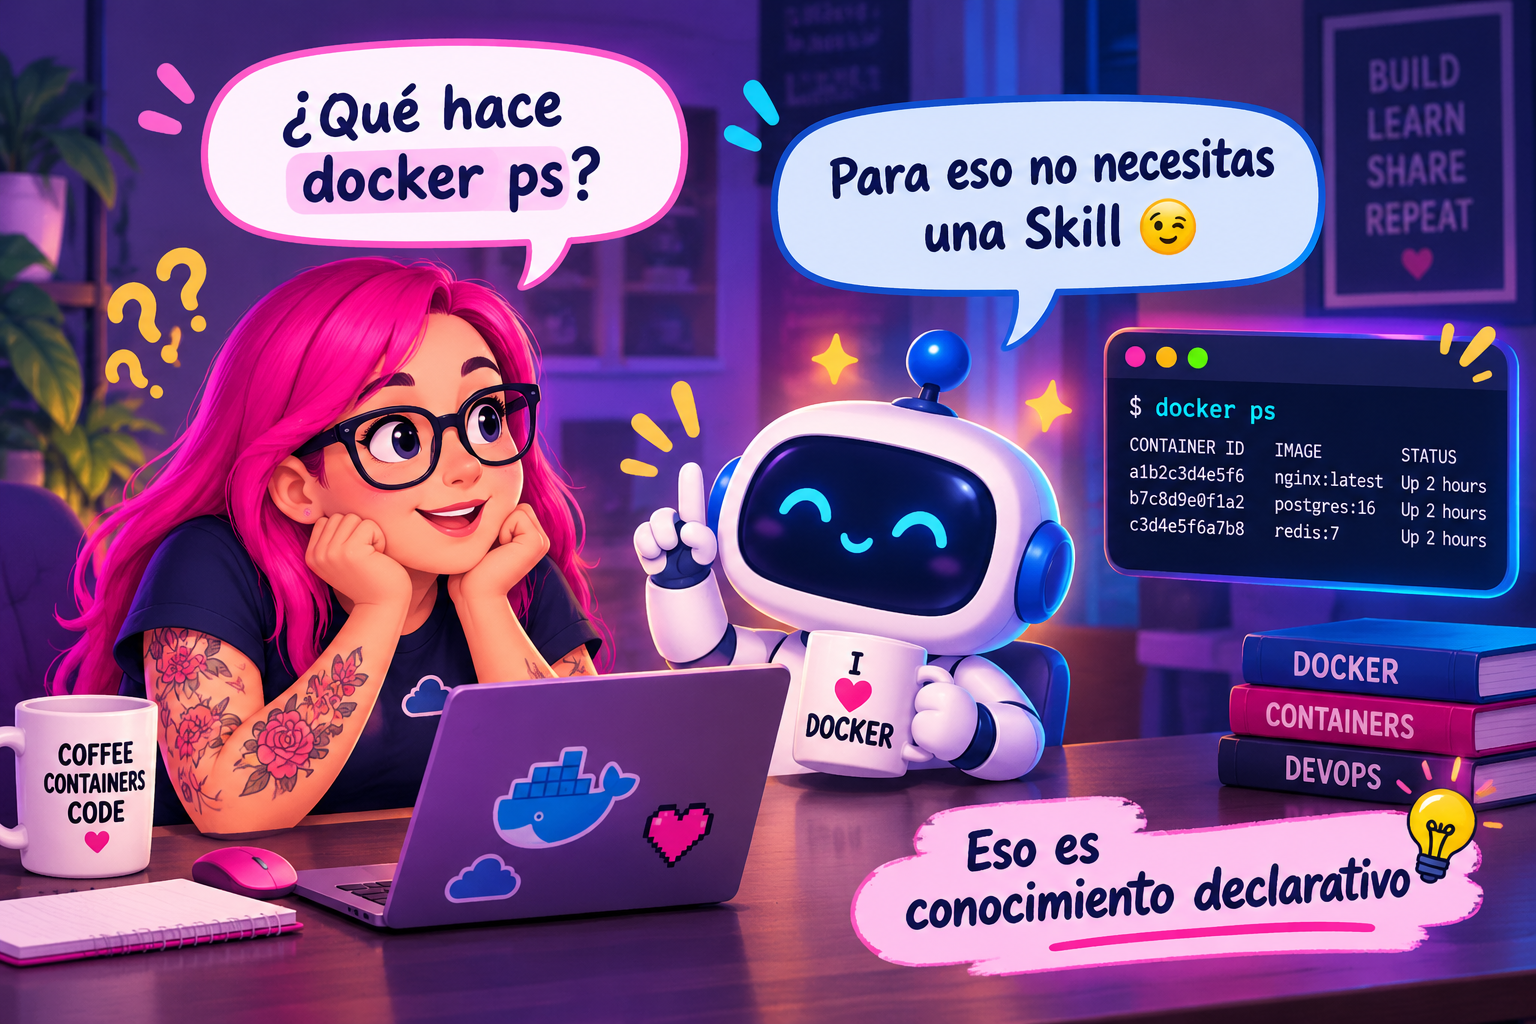
Un modelo puede responder perfectamente.
Pero cambia cuando pedimos:
Containerizá este repositorio.
O:
Optimizá esta imagen para producción.
O:
Construí un entorno Compose para toda la aplicación.
O:
Eliminá recursos Docker que ya no necesitamos sin romper mi entorno.
Ahí ya no estamos preguntando algo.
Estamos delegando trabajo.
Y cuanto más trabajo delegamos, más valor tiene disponer de procedimientos reutilizables.
El verdadero tema no es Docker
Esta es probablemente la parte que más me interesa de todo esto.
Docker Skills es un proyecto relacionado con Docker.
Pero el patrón es mucho más grande.
Hoy muchas organizaciones tienen años de conocimiento distribuidos entre:
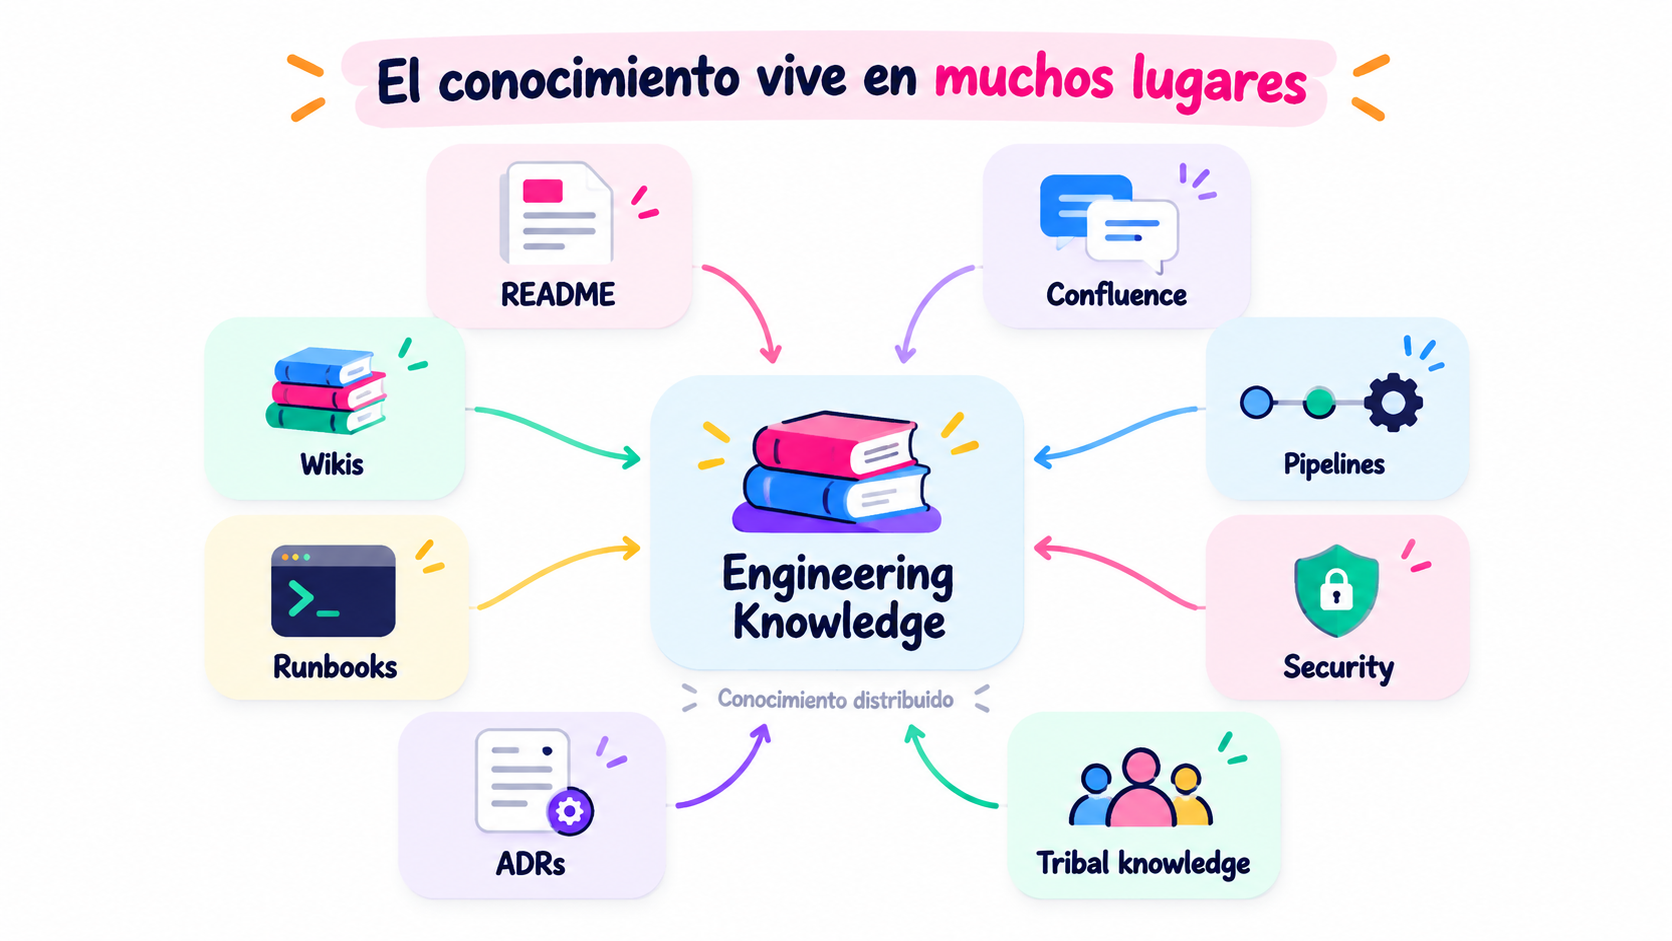
Ese conocimiento fue diseñado principalmente para que una persona lo lea.
Ahora imaginemos un futuro cercano donde parte importante de los cambios son realizados por agentes.
Esos agentes también van a necesitar conocer:
cómo construimos software,
qué patrones preferimos,
qué prácticas están prohibidas,
qué validaciones son obligatorias,
qué acciones necesitan aprobación,
cómo desplegamos,
cómo hacemos rollback,
cómo respondemos ante determinados errores.
Y probablemente no queramos meter todo eso dentro de cada prompt.
Necesitamos mecanismos para convertir conocimiento organizacional en contexto operativo reutilizable.
Skills es una de las propuestas que están apareciendo para resolverlo.
De documentación pasiva a conocimiento operativo
Durante mucho tiempo escribimos documentación esperando que alguien la leyera.
La generación actual de herramientas nos obliga a pensar diferente.
Quizás parte de nuestra documentación ya no solamente tenga que explicar:
cómo hacemos las cosas
sino también convertirse en algo que una máquina pueda utilizar para:
hacer las cosas de esa manera.
Ese cambio parece pequeño.
Pero puede modificar muchísimo cómo diseñamos plataformas internas, pipelines y Developer Experience durante los próximos años.
Docker Skills es todavía un proyecto en evolución y Docker aclara que la colección no cubre todos sus productos.
Pero la dirección resulta interesante.
El siguiente paso de los coding agents quizás no sea solamente darles modelos más inteligentes.
Puede ser darles:
mejor contexto
+
mejores procedimientos
+
mejores herramientas
+
mejores guardrails
Porque saber hacer algo no garantiza hacerlo siempre bien.
Y en ingeniería, la consistencia también es una feature.
Para probarlo
Repositorio oficial:
github.com/docker/skills
Documentación:
docs.docker.com/ai/skills/
Mi recomendación: no te quedes solamente leyendo las Skills.
Instalá una, abrí un repositorio real y compará qué propone tu coding agent con y sin ella.
Ahí es donde la idea se vuelve mucho más clara.
El modelo aporta inteligencia.
La Skill aporta contexto y forma de trabajo.
Y nosotros seguimos aportando criterio.
🔥 Build with fire. Deploy with power.